Gram-Schmidt正交化与QR分解

  • Gram-Schmidt算法可以将线性无关的向量{a⃗1,⋯ ,a⃗k}\{\vec{a}_1,\cdots,\vec{a}_k\}转换为正交基向量{q⃗1,⋯ ,q⃗k}\{\vec{q}_1 ,\cdots ,\vec{q}_k\}(范数均为11且相互正交),且其张成的空间不变。
  • 下面我们从二维情形开始推导正交基向量的计算方法:
    • 设初始的两个不共线向量为a⃗1\vec{a}_1和a⃗2\vec{a}_2,则第一个正交基向量可直接由a⃗1\vec{a}_1归一化得到: q⃗1≐a⃗1∥a⃗1∥2.\vec{q}_1\doteq\frac{\vec{a}_1}{\|\vec{a}_1\|_2}.
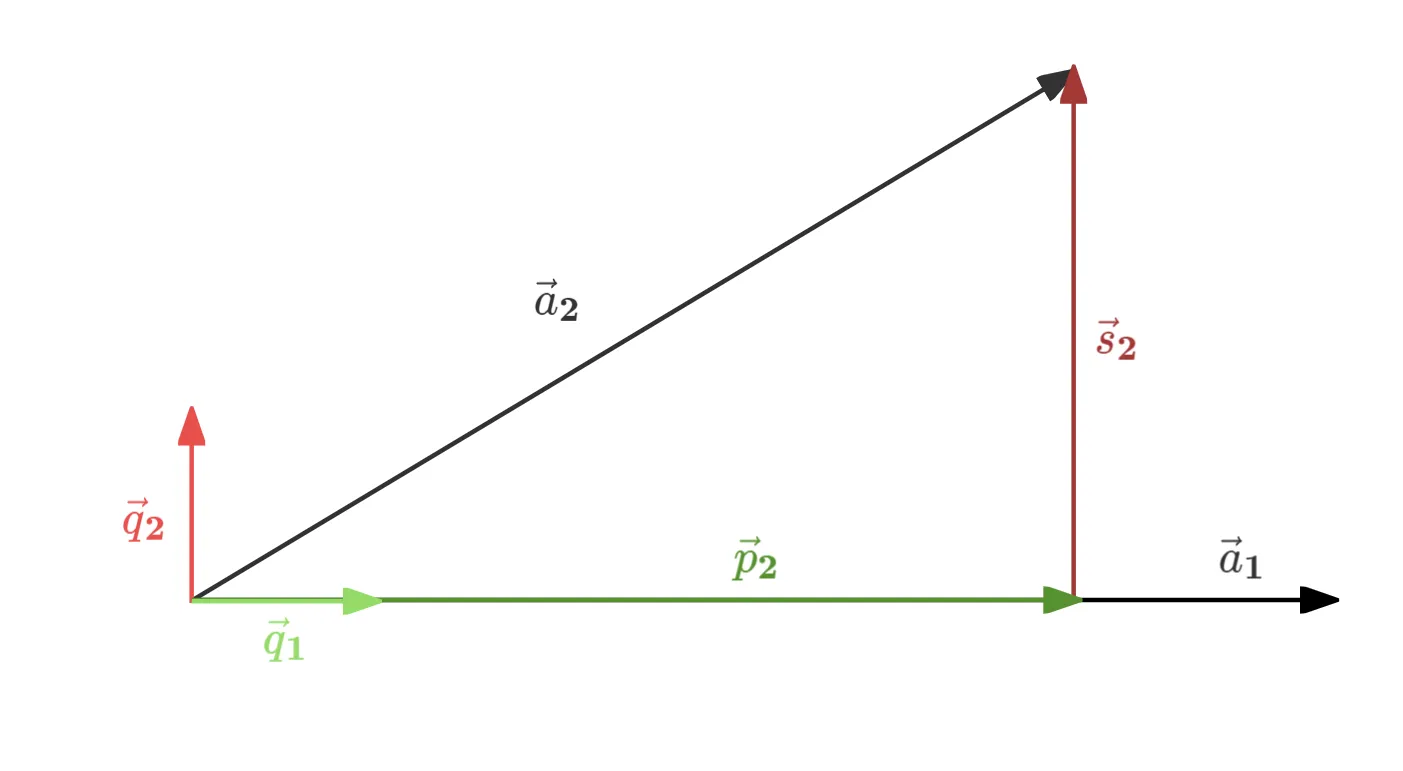
    • 为了得到第二个正交基向量,我们需要利用a⃗2\vec{a}_2在a⃗1\vec{a}_1上的投影向量: p⃗2≐q⃗1(q⃗1⊤a⃗2),\vec{p}_2\doteq\vec{q}_1(\vec{q}_1^\top\vec{a}_2), 如果∥p⃗2∥2=0\|\vec{p}_2\|_2=0,则直接对a⃗2\vec{a}_2归一化得到q⃗2\vec{q}_2;否则,将a⃗2\vec{a}_2与投影向量p⃗2\vec{p}_2相减就得到与q⃗1\vec{q}_1垂直的向量: s⃗2≐a⃗2−p⃗2=a⃗2−q⃗1(q⃗1⊤a⃗2),\vec{s}_2\doteq\vec{a}_2-\vec{p}_2=\vec{a}_2-\vec{q}_1(\vec{q}_1^\top\vec{a}_2), 最后对s⃗2\vec{s}_2进行归一化,就得到第二个正交基向量: q⃗2=s⃗2∥s⃗2∥2.\vec{q}_2=\frac{\vec{s}_2}{\|\vec{s}_2\|_2}.
    • 图示如下:
      gram
  • 更高维的情况类似,核心方法就是先构造当前向量在前面向量组成平面上的投影向量,相减得到垂直向量,最后进行归一化。我们给出nn维情形的公式: {q⃗1=a⃗1∥a⃗1∥2,s⃗2=a⃗2−q⃗1(q⃗1⊤a⃗2)⟹q⃗2=s⃗2∥s⃗2∥2,s⃗3=a⃗3−q⃗1(q⃗1⊤a⃗3)−q⃗2(q⃗2⊤a⃗3)⟹q⃗3=s⃗3∥s⃗3∥2,⋮s⃗n=a⃗n−q⃗1(q⃗1⊤a⃗n)−⋯−q⃗n−1(q⃗n−1⊤a⃗n)⟹q⃗n=s⃗n∥s⃗n∥2\begin{cases} \displaystyle\vec{q}_1 = \frac{\vec{a}_1}{\|\vec{a}_1\|_2} ,\\ \displaystyle\vec{s}_2 = \vec{a}_2 - \vec{q}_1 (\vec{q}_1^\top \vec{a}_2)\Longrightarrow\vec{q}_2 = \frac{\vec{s}_2}{\|\vec{s}_2\|_2} ,\\ \displaystyle\vec{s}_3 = \vec{a}_3 - \vec{q}_1 (\vec{q}_1^\top \vec{a}_3) - \vec{q}_2 (\vec{q}_2^\top \vec{a}_3)\Longrightarrow\vec{q}_3 = \frac{\vec{s}_3}{\|\vec{s}_3\|_2},\\ \vdots\\ \displaystyle\vec{s}_n = \vec{a}_n - \vec{q}_1 (\vec{q}_1^\top \vec{a}_n) - \cdots - \vec{q}_{n-1} (\vec{q}_{n-1}^\top \vec{a}_n)\Longrightarrow\vec{q}_n = \frac{\vec{s}_n}{\|\vec{s}_n\|_2} \end{cases}

QR分解

  • 因为对于每个i∈{1,2,⋯ ,k}i\in\{1,2,\cdots,k\},(a⃗1,⋯ ,a⃗i)(\vec{a}_1,\cdots,\vec{a}_i)张成的空间与(q⃗1,⋯ ,q⃗i)(\vec{q}_1,\cdots,\vec{q}_i)相同,所以a⃗i\vec{a}_i可以由(q⃗1,⋯ ,q⃗i)(\vec{q}_1,\cdots,\vec{q}_i)线性表示: a⃗i=r1iq⃗1+⋯+riiq⃗i=∑j=1irjiq⃗j\vec{a}_i=r_{1i}\vec{q}_1+\cdots+r_{ii}\vec{q}_i=\sum_{j=1}^i r_{ji}\vec{q}_j 那么将所有ai⃗\vec{a_i}的表示排在一起,就组成了矩阵: [a⃗1⋯a⃗k]=[q⃗1⋯q⃗k][r11r12⋯r1k0r22⋯r2k⋯⋯⋱⋯00⋯rkk].[\vec{a}_1\quad\cdots\quad\vec{a}_k]=[\vec{q}_1\quad\cdots\quad\vec{q}_k]\begin{bmatrix} r_{11} &r_{12} &\cdots &r_{1k}\\ 0 &r_{22} &\cdots &r_{2k}\\ \cdots &\cdots &\ddots &\cdots\\ 0&0&\cdots&r_{kk} \end{bmatrix}. 也就是说,我们可以将任意列满秩矩阵分解为一组正交基矩阵QQ和上三角矩阵RR的乘积。
  • 定理表述如下:设A∈Rn×kA \in \mathbb{R}^{n \times k},其中k≤nk \leq n(即AA是“高”矩阵,保证列向量线性无关)。假设AA列满秩,则存在一个具有标准正交列的矩阵Q∈Rn×kQ \in \mathbb{R}^{n \times k},以及一个上三角矩阵R∈Rk×kR \in \mathbb{R}^{k \times k},使得A=QRA = QR。
  • 当然,也有针对宽矩阵(k>nk>n)以及非列满秩矩阵的QR分解方法,此处不作讨论。(可参考:URV分解)

线性代数基本定理(Fundamental Theorem of Linear Algebra)

注:要和代数基本定理作区分。

  • 线性代数基本定理可以帮助我们进一步理解向量及其张成空间在线性变换下发生的变化。事实上,矩阵乘法的本质就是将一个向量空间转换为另一个向量空间(或者理解为转换坐标系),从而将问题进行转化(简化)。
  • 在阐述定理之前,我们首先定义直和(direct sum):
    • 设U,VU,V是Rn\R^n上的子空间,若:

      1. 任意x⃗∈Rn\vec{x}\in\R^n可表示为x⃗=x⃗1+x⃗2\vec{x}=\vec{x}_1+\vec{x}_2,其中x⃗1∈U,x⃗2∈V\vec{x}_1\in U,\vec{x}_2\in V;
      2. 上述向量分解唯一,即如果存在两个分解x⃗=x⃗1+x⃗2=y⃗1+y⃗2\vec{x}=\vec{x}_1+\vec{x}_2=\vec{y}_1+\vec{y}_2,那么x⃗1=y⃗1,x⃗2=y⃗2\vec{x}_1=\vec{y}_1,\vec{x}_2=\vec{y}_2,

      则称U,VU,V的直和为Rn\R^n,记为U⊕V=RnU\oplus V=\R^n。

  • 由此我们可以得到线性代数基本定理:设A∈Rm×nA\in\R^{m\times n},则 N(A)⊕R(A⊤)=Rn,\mathcal{N}(A)\oplus\mathcal{R}(A^\top)=\R^n, 其中N(A)\mathcal{N}(A)表示AA的零空间(即Ax⃗=0A\vec{x}=0的解空间),而R(A⊤)\mathcal{R}(A^\top)则表示AA的行向量组成的空间,与N(A)\mathcal{N}(A)形成正交。
    • 当然我们也可以得到以下推论:设A∈Rm×nA\in\R^{m\times n},则 N(A⊤)⊕R(A)=Rm.\mathcal{N}(A^\top)\oplus\mathcal{R}(A)=\R^m.
  • 下面我们给出这个定理的证明:
    • 首先我们给出正交补空间的定义:设SS为Rn\R^n上子空间,则SS的正交补空间(orthogonal complement,记作S⊥S^\perp)定义如下: S⊥={x⃗∈Rn∣s⃗⊤x⃗=0,∀s⃗∈S}.S^\perp=\{\vec{x}\in\R^n\mid\vec{s}^\top\vec{x}=0,\forall \vec{s}\in S\}.
    • 由此我们可以得到正交分解定理:设SS为Rn\R^n上子空间,则 S⊕S⊥=Rn.S\oplus S^\perp=\R^n. 对这个定理的证明主要利用了直和的性质和S∩S⊥={0}S\cap S^\perp=\{0\}。(具体过程留给读者)
    • 有了这个定理,我们就只需要证明N(A)=R(A⊤)⊥\mathcal{N}(A)=\mathcal{R}(A^\top)^\perp。
      1. N(A)⊆R(A⊤)⊥\mathcal{N}(A)\subseteq\mathcal{R}(A^\top)^\perp:即证任意x⃗∈N(A)\vec{x}\in\mathcal{N}(A),对任意y⃗∈R(A⊤)\vec{y}\in\mathcal{R}(A^\top),满足y⃗⊤x⃗=0\vec{y}^\top\vec{x}=0。
        • 因为y⃗∈R(A⊤)\vec{y}\in\mathcal{R}(A^\top),所以y⃗=A⊤w⃗\vec{y}=A^\top\vec{w}(w⃗∈Rm\vec{w}\in\R^m),又因为x⃗∈N(A)\vec{x}\in\mathcal{N}(A),所以Ax⃗=0⃗A\vec{x}=\vec{0},故 y⃗⊤x⃗=(A⊤w⃗)⊤x⃗=w⃗⊤Ax⃗=w⃗⊤0⃗=0.\vec{y}^\top\vec{x}=(A^\top\vec{w})^\top\vec{x}=\vec{w}^\top A\vec{x}=\vec{w}^\top\vec{0}=0.
      2. R(A⊤)⊥⊆N(A)\mathcal{R}(A^\top)^\perp\subseteq\mathcal{N}(A):
        • 对任意x⃗∈R(A⊤)⊥\vec{x}\in\mathcal{R}(A^\top)^\perp,任意y⃗∈R(A⊤)\vec{y}\in\mathcal{R}(A^\top),满足y⃗⊤x⃗=0\vec{y}^\top\vec{x}=0。又y⃗=A⊤w⃗\vec{y}=A^\top\vec{w}(w⃗∈Rm\vec{w}\in\R^m),所以(A⊤w⃗)⊤x⃗=w⃗⊤Ax⃗=0(A^\top\vec{w})^\top\vec{x}=\vec{w}^\top A\vec{x}=0对任意w⃗∈Rm\vec{w}\in\R^m均成立。
          那么取w⃗=Ax⃗\vec{w}=A\vec{x},则 0=w⃗⊤Ax⃗=(Ax⃗)⊤Ax⃗=∥Ax⃗∥22.0=\vec{w}^\top A\vec{x}=(A\vec{x})^\top A\vec{x}=\|A\vec{x}\|_2^2. 因此Ax⃗=0⃗A\vec{x}=\vec{0},即x⃗∈N(A)\vec{x}\in\mathcal{N}(A)。
    • 综上,定理得证。
  • 下面我们利用这个定理解决一个重要的优化问题(可看作最小二乘问题的对偶问题):
    • 对于线性方程组Ax⃗=y⃗A\vec{x}=\vec{y},当AA为宽矩阵(即行数小于列数)且行满秩,则方程组有无穷个解,此时我们常常选取范数最小的解。于是我们就能得到以下优化问题: min⁡∥x⃗∥22s.t.Ax⃗=y⃗.\begin{aligned} \min \|\vec{x}\|_2^2\\ s.t.\quad A\vec{x}=\vec{y}. \end{aligned} 其最优解为 x⃗∗=A⊤(AA⊤)−1y⃗.\vec{x}^*=A^\top(AA^\top)^{-1}\vec{y}.
    • 简单证明:
      由线性代数基本定理,设x⃗=u⃗+v⃗\vec{x}=\vec{u}+\vec{v},其中u⃗∈N(A),v⃗∈R(A⊤)\vec{u}\in\mathcal{N}(A),\vec{v}\in\mathcal{R}(A^\top)。那么存在w⃗∈Rm\vec{w}\in\R^m使v⃗=A⊤w⃗\vec{v}=A^\top\vec{w}。
      于是目标函数 ∥x⃗∥22=∥u⃗+v⃗∥22=u⃗⊤u⃗+2u⃗⊤v⃗+v⃗⊤v⃗=∥u⃗∥22+2v⃗⊤u⃗+∥v⃗∥22=∥u⃗∥22+2(A⊤w⃗)⊤u⃗+∥v⃗∥22=∥u⃗∥22+2w⃗⊤Au⃗+∥v⃗∥22=∥u⃗∥22+2w⃗⊤0⃗+∥v⃗∥22=∥u⃗∥22+2⋅0+∥v⃗∥22=∥u⃗∥22+∥v⃗∥22=∥u⃗∥22+∥A⊤w⃗∥22.\begin{aligned} \left\|\vec{x}\right\|_{2}^{2} & =\left\|\vec{u}+\vec{v}\right\|_{2}^{2} \\ & =\vec{u}^\top\vec{u}+2\vec{u}^\top\vec{v}+\vec{v}^\top\vec{v} \\ & =\left\|\vec{u}\right\|_2^2+2\vec{v}^\top\vec{u}+\left\|\vec{v}\right\|_2^2 \\ & =\left\|\vec{u}\right\|_2^2+2(A^\top\vec{w})^\top\vec{u}+\left\|\vec{v}\right\|_2^2 \\ & =\left\|\vec{u}\right\|_2^2+2\vec{w}^\top A\vec{u}+\left\|\vec{v}\right\|_2^2 \\ & =\left\|\vec{u}\right\|_2^2+2\vec{w}^\top\vec{0}+\left\|\vec{v}\right\|_2^2 \\ & =\left\|\vec{u}\right\|_2^2+2\cdot0+\left\|\vec{v}\right\|_2^2 \\ & =\left\|\vec{u}\right\|_2^2+\left\|\vec{v}\right\|_2^2 \\ & =\left\|\vec{u}\right\|_2^2+\left\|A^\top\vec{w}\right\|_2^2. \end{aligned} (本质就是勾股定理)约束条件变为 y⃗=Ax⃗=A(u⃗+v⃗)=Au⃗+Av⃗=0⃗+AA⊤w⃗=AA⊤w⃗.\begin{aligned} \vec{y}&=A\vec{x} \\ & =A(\vec{u}+\vec{v}) \\ & =A\vec{u}+A\vec{v} \\ & =\vec{0}+AA^\top\vec{w} \\ & =AA^\top\vec{w}. \\ \end{aligned} 又因为AA−1AA^{-1}可逆,所以w⃗∗=(AA⊤)−1y⃗⟹v⃗∗=A⊤(AA⊤)−1y⃗\vec{w}^*=(AA^\top)^{-1}\vec{y}\Longrightarrow\vec{v}^*=A^\top(AA^\top)^{-1}\vec{y}。而∥u⃗∥22\|\vec{u}\|_2^2与约束条件无关,故可直接取u⃗∗=0⃗\vec{u}^*=\vec{0}。
      • 综上,x⃗∗=A⊤(AA⊤)−1y⃗\vec{x}^*=A^\top(AA^\top)^{-1}\vec{y},定理得证。

对称矩阵(Symmetric Matrices)

对称矩阵是一类特殊的矩阵,具有一些良好的性质。

  • 定义:设A∈Rn×nA\in\R^{n\times n}是方阵,则如果A=A⊤A=A^\top,则称AA是对称矩阵。对称矩阵的全体记作Sn\mathbb{S}^n.
    • 例:协方差矩阵,无向图的邻接矩阵都是对称矩阵。
  • 若AA为对称矩阵,则其具有以下性质:
    1. AA的所有特征值λi,1≤i≤n\lambda_i,1\leq i\leq n均为实数;
    2. AA的所有特征子空间{Φi=N(λiI−A),1≤i≤n}\{\Phi_i=\mathcal{N}(\lambda_iI-A),1\leq i\leq n\}两两正交;
    3. AA的特征值λi\lambda_i对应的特征子空间维度dim(Φi)\mathrm{dim}(\Phi_i)等于λi\lambda_i的重数(即∣λI−A∣|\lambda I-A|中(λ−λi)(\lambda-\lambda_i)的次数);
    4. A=U⊤ΛUA=U^\top\Lambda U,其中UU为正交矩阵(列向量相互正交且范数为11),Λ\Lambda为对角矩阵。(也称为谱定理(Spectral Theorem))
  • 性质1和2可在线性代数(高等代数)教材中找到证明(可参见实对称矩阵的标准形)。下面只证明性质4(性质3可直接由性质4的矩阵结构推得):

性质4(谱定理)的证明

我们使用归纳法进行证明:

  • 初始条件:当n=1n=1时,矩阵AA显然可以正交对角化;
  • 归纳假设:假设对所有n−1n-1阶对称矩阵,都存在正交对角化;
  • 归纳步骤:
    我们首先证明一个引理:设A∈SnA\in\mathbb{S}^n,λ\lambda为AA的一个特征值,则存在一个标准正交矩阵UU使得 U⊤AU=[λ0⊤0B]U^\top AU=\begin{bmatrix} \lambda &0^\top\\ 0 & B \end{bmatrix} 其中B∈Sn−1B\in\mathbb{S}^{n-1}。
    • 证明如下:设v⃗\vec{v}为特征值λ\lambda对应的一个单位特征向量(列向量,范数为11),那么我们可以用施密特正交化方法将其扩充为一组标准正交基,进而得到标准正交矩阵U=[v⃗U1]∈Rn×nU=[\vec{v}\quad U_1]\in\R^{n\times n},有U1⊤v⃗=0⃗,v⃗⊤U1=0⃗⊤U_1^\top\vec{v}=\vec{0},\vec{v}^\top U_1=\vec{0}^\top。于是 U⊤AU=[v⃗⊤U1⊤]A[v⃗U1]=[v⃗⊤U1⊤][Av⃗AU1]=[v⃗⊤U1⊤][λv⃗AU1]=[λv⃗⊤v⃗v⃗⊤AU1λU1⊤v⃗U1⊤AU1]=[λ∥v⃗∥22(A⊤v⃗)⊤U10⃗U1⊤AU1]=[λ(Av⃗)⊤U10⃗U1⊤AU1]=[λλv⃗⊤U10⃗U1⊤AU1]=[λ0⃗⊤0⃗U1⊤AU1]=[λ0⃗⊤0⃗B],\begin{aligned} U^\top AU&=\begin{bmatrix} \vec{v}^\top\\ U_1^\top \end{bmatrix}A\begin{bmatrix} \vec{v}& U_1 \end{bmatrix}\\ &=\begin{bmatrix} \vec{v}^\top\\ U_1^\top \end{bmatrix}\begin{bmatrix} A\vec{v}& AU_1 \end{bmatrix}=\begin{bmatrix} \vec{v}^\top\\ U_1^\top \end{bmatrix}\begin{bmatrix} \lambda\vec{v}& AU_1 \end{bmatrix}\\ &=\begin{bmatrix} \lambda\vec{v}^\top\vec{v}&\vec{v}^\top AU_1\\ \lambda U_1^\top\vec{v}&U_1^\top AU_1 \end{bmatrix}\\ &=\begin{bmatrix} \lambda\|\vec{v}\|_2^2&(A^\top\vec{v})^\top U_1\\ \vec{0}&U_1^\top AU_1 \end{bmatrix}= \begin{bmatrix} \lambda&(A\vec{v})^\top U_1\\ \vec{0}&U_1^\top AU_1 \end{bmatrix}\\ &=\begin{bmatrix} \lambda&\lambda\vec{v}^\top U_1\\ \vec{0}&U_1^\top AU_1 \end{bmatrix}\\ &=\begin{bmatrix} \lambda&\vec{0}^\top\\ \vec{0}&U_1^\top AU_1 \end{bmatrix}\\ &=\begin{bmatrix} \lambda&\vec{0}^\top\\ \vec{0}&B \end{bmatrix}, \end{aligned} 其中B=U1⊤AU1B=U_1^\top AU_1是n−1n-1维方阵。我们再证明BB是对称矩阵: B⊤=(U1⊤AU1)⊤=(U1)⊤A⊤(U1⊤)⊤=U1⊤AU1=B.B^\top=(U_1^\top AU_1)^\top=(U_1)^\top A^\top (U_1^\top)^\top=U_1^\top AU_1=B. 从而引理得证。
    • 下面我们基于这个引理进行归纳:由归纳假设可知B=WΓW⊤B=W\Gamma W^\top,其中WW为正交矩阵(满足W−1=WW^{-1}=W),Γ\Gamma为对角矩阵,于是 Γ=W⊤BW=W⊤U1⊤AU1W=(U1W)⊤A(U1W)\Gamma=W^\top BW=W^\top U_1^\top AU_1W=(U_1W)^\top A(U_1W) 那么我们就可以令U=[v⃗U1W]U=\begin{bmatrix}\vec{v}\quad U_1W\end{bmatrix},则 U⊤AU=[v⃗⊤W⊤U1⊤]A[v⃗U1W]=⋯=[λv⃗⊤v⃗v⃗⊤AU1WλW⊤U1⊤v⃗W⊤U1⊤AU1W]=⋯=[λ0⃗⊤0⃗Γ]=Λ,\begin{aligned} U^\top AU&=\begin{bmatrix} \vec{v}^\top\\ W^\top U_1^\top \end{bmatrix}A\begin{bmatrix} \vec{v}& U_1W \end{bmatrix}\\ &=\cdots\\ &=\begin{bmatrix} \lambda\vec{v}^\top\vec{v}&\vec{v}^\top AU_1W\\ \lambda W^\top U_1^\top\vec{v}&W^\top U_1^\top AU_1W \end{bmatrix}\\ &=\cdots\\ &=\begin{bmatrix} \lambda&\vec{0}^\top\\ \vec{0}&\Gamma \end{bmatrix}=\Lambda, \end{aligned} 因此A=U⊤ΛUA=U^\top\Lambda U,即AA可以被对角化,定理得证。□\square
  • 事实上,这个对角矩阵Λ\Lambda对角线上的元素就是AA的特征值,UU就是特征值对应的特征向量。
  • 另外,我们也可以通过这种分解得到N(A)\mathcal{N}(A)与R(A⊤)\mathcal{R}(A^\top)的基。事实上,只需要在UU中找到特征值为00对应的特征向量,其就能组成N(A)\mathcal{N}(A)的基(剩下的特征向量则组成R(A⊤)\mathcal{R}(A^\top)的基)。
  • 对于非对称矩阵或非方阵,我们还有另一种分解方式——奇异值分解(SVD),这会在之后进行阐述。

Rayleigh商

  • 对于对称矩阵,我们再介绍一个针对其特征值的优化命题,即下述特征值的变分刻画:
    • 设A∈SnA\in\mathbb{S}^n,λmax⁡{A}\lambda_{\max}\{A\}与λmax⁡{A}\lambda_{\max}\{A\}分别表示AA的最大与最小特征值,那么 λmax⁡{A}=max⁡x⃗∈Rn,x⃗≠0⃗x⃗⊤Ax⃗x⃗⊤x⃗=max⁡x⃗∈Rn∥x⃗∥2=1x⃗⊤Ax⃗λmin⁡{A}=min⁡x⃗∈Rn,x⃗≠0⃗x⃗⊤Ax⃗x⃗⊤x⃗=min⁡x⃗∈Rn∥x⃗∥2=1x⃗⊤Ax⃗.\begin{aligned} \lambda_{\max}\{A\} = \max_{\vec{x} \in \mathbb{R}^n, \vec{x} \neq \vec{0}} \frac{\vec{x}^\top A \vec{x}}{\vec{x}^\top \vec{x}} = \max_{\begin{subarray}{c}\vec{x} \in \mathbb{R}^n \\ \|\vec{x}\|_2 = 1\end{subarray}} \vec{x}^\top A \vec{x}\\ \lambda_{\min}\{A\} = \min_{\begin{subarray}{c}\vec{x} \in \mathbb{R}^n, \vec{x} \neq \vec{0}\end{subarray}} \frac{\vec{x}^\top A \vec{x}}{\vec{x}^\top \vec{x}} = \min_{\begin{subarray}{c}\vec{x} \in \mathbb{R}^n \\ \|\vec{x}\|_2 = 1\end{subarray}} \vec{x}^\top A \vec{x}. \end{aligned} 其中x⃗⊤Ax⃗x⃗⊤x⃗\dfrac{\vec{x}^\top A \vec{x}}{\vec{x}^\top \vec{x}}也称为AA的Rayleigh商,是关于x⃗\vec{x}的函数。
    • 证明如下:
      • 我们首先举例说明Rayleigh商的最大值与最小值能够取到。取x⃗\vec{x}为λmax⁡{A}\lambda_{\max}\{A\}对应的特征向量,则 x⃗⊤Ax⃗x⃗⊤x⃗=x⃗⊤λmax⁡{A}x⃗x⃗⊤x⃗=λmax⁡{A}.\frac{\vec{x}^\top A \vec{x}}{\vec{x}^\top \vec{x}}=\frac{\vec{x}^\top\lambda_{\max}\{A\}\vec{x}}{\vec{x}^\top \vec{x}}=\lambda_{\max}\{A\}. λmin⁡{A}\lambda_{\min}\{A\}同理。
      • 接下来我们证明Rayleigh商的上界为λmax⁡{A}\lambda_{\max}\{A\}:由谱定理, x⃗⊤Ax⃗=x⃗⊤UΛU⊤x⃗=(U⊤x⃗)⊤Λ(U⊤x⃗)=y⃗=U⊤x⃗y⃗⊤Λy⃗=∑i=1nλiyi2.\begin{aligned} \vec{x}^\top A\vec{x}&=\vec{x}^\top U\Lambda U^\top\vec{x}\\ &=(U^\top\vec{x})^\top\Lambda(U^\top\vec{x})\\ &\xlongequal{\vec{y}=U^\top\vec{x}}\vec{y}^\top\Lambda\vec{y}\\ &=\sum_{i=1}^n\lambda_iy_i^2. \end{aligned} 又因为 max⁡x⃗∈Rn,x⃗≠0⃗x⃗⊤Ax⃗x⃗⊤x⃗=max⁡x⃗∈Rn,x⃗≠0⃗x⃗⊤Ax⃗∥x⃗∥22=max⁡x⃗∈Rn,x⃗≠0⃗(x⃗∥x⃗∥2)⊤A(x⃗∥x⃗∥2)=max⁡x⃗∈Rn∥x⃗∥2=1x⃗⊤Ax⃗\begin{aligned} \max_{\vec{x} \in \mathbb{R}^n, \vec{x} \neq \vec{0}} \frac{\vec{x}^\top A \vec{x}}{\vec{x}^\top \vec{x}} &= \max_{\vec{x} \in \mathbb{R}^n, \vec{x} \neq \vec{0}} \frac{\vec{x}^\top A \vec{x}}{\|\vec{x}\|_2^2}\\ &= \max_{\vec{x} \in \mathbb{R}^n, \vec{x} \neq \vec{0}} \left( \frac{\vec{x}}{\|\vec{x}\|_2} \right)^\top A \left( \frac{\vec{x}}{\|\vec{x}\|_2} \right)\\ &=\max_{\begin{subarray}{c}\vec{x} \in \mathbb{R}^n \\ \|\vec{x}\|_2 = 1\end{subarray}} \vec{x}^\top A \vec{x} \end{aligned} 且∥y⃗∥22=∥U⊤x⃗∥22=x⃗⊤UU⊤x⃗=x⃗⊤x⃗=∥x⃗∥22\|\vec{y}\|_2^2 = \left\| U^\top \vec{x} \right\|_2^2 = \vec{x}^\top U U^\top \vec{x} = \vec{x}^\top \vec{x} = \|\vec{x}\|_2^2,所以 max⁡x⃗∈Rnx⃗⊤Ax⃗=max⁡y⃗∈Rn∑i=1nλiyi2≤λmax⁡{A}⋅max⁡y⃗∈Rn∑i=1nyi2=λmax⁡{A}⋅max⁡y⃗∈Rn∥y⃗∥22=λmax⁡{A}⋅max⁡y⃗∈Rn1=λmax⁡{A}.\begin{aligned} \max_{\vec{x} \in \mathbb{R}^n} \vec{x}^\top A \vec{x} &= \max_{\vec{y} \in \mathbb{R}^n} \sum_{i=1}^n \lambda_i y_i^2\\ &\leq \lambda_{\max} \{A\} \cdot \max_{\vec{y} \in \mathbb{R}^n} \sum_{i=1}^n y_i^2\\ &= \lambda_{\max} \{A\} \cdot \max_{\vec{y} \in \mathbb{R}^n} \|\vec{y}\|_2^2\\ &= \lambda_{\max} \{A\} \cdot \max_{\vec{y} \in \mathbb{R}^n} 1\\ &= \lambda_{\max} \{A\}. \end{aligned} λmin⁡{A}\lambda_{\min}\{A\}同理,于是命题得证。

正定矩阵与半正定矩阵

  • 基于这个命题,我们还可以作以下定义:
    • 设A∈SnA\in\mathbb{S}^n,则如果对任意x⃗\vec{x},x⃗⊤Ax⃗≥0\vec{x}^\top A\vec{x}\geq 0,则称AA为半正定矩阵(positive semidefinite,PSD),记作S+n\mathbb{S}^n_+;
    • 如果任意x⃗≠0⃗\vec{x}\neq\vec{0},x⃗⊤Ax⃗>0\vec{x}^\top A\vec{x}> 0,则称AA为正定矩阵(positive definite,PD),记作S++n\mathbb{S}^n_{++}。
    • 类似可定义半负定矩阵、负定矩阵等。
  • 显然,正定矩阵属于半正定矩阵,且半正定矩阵的所有特征值均非负,正定矩阵的所有特征值均为正数。(反之同样成立,但前提是对称矩阵)
  • 半正定矩阵的平方根:设A∈S+nA\in\mathbb{S}^n_+,则存在唯一的半正定矩阵B∈S+nB\in\mathbb{S}^n_+使得A=B2A=B^2(此时BB也记作A1/2A^{1/2})。
    • 实际上,若A=U⊤ΛUA=U^\top\Lambda U,则只需要令B=U⊤Λ1/2UB=U^\top\Lambda^{1/2}U即可。