在之前的岭回归与Elastic Net优化问题中,我们已经涉及到正则化的使用。下面我们将进一步讨论正则化问题。

正则化(Regularization)

  • 我们首先对正则化进行正式定义:考虑如下优化问题 p∗=min⁡x⃗∈Ωf0(x⃗)p^*=\min_{\vec{x}\in\Omega}f_0(\vec{x}) 引入正则项(函数)R:Ω→R+R:\Omega\to\R_+和正则化参数λ>0\lambda>0,则上述问题的正则化形式为 pλ∗=min⁡x⃗∈Ω{f0(x⃗)+λR(x⃗)}p^*_\lambda=\min_{\vec{x}\in\Omega}\{f_0(\vec{x})+\lambda R(\vec{x})\} 其中λ\lambda可以调节正则化的强度。
    • 注:当参数λ\lambda变化时,对应的最优解也会变化。
  • 之前的岭回归问题中,我们使用的正则项是ℓ2\ell^2-范数R(x⃗)=∥x⃗∥22R(\vec{x})=\|\vec{x}\|_2^2,而下面我们将主要讨论另一种正则项:ℓ1\ell^1-范数,即R(x⃗)=∥x⃗∥1=∑i=1n∣xi∣R(\vec{x})=\|\vec{x}\|_1=\displaystyle\sum_{i=1}^n|x_i|。使用这一正则项的最典型优化问题就是LASSO回归问题。

LASSO回归

  • LASSO回归的形式如下:

    min⁡x⃗∈Rn{∥Ax⃗−y⃗∥22+λ∥x⃗∥1}\min_{\vec{x} \in \mathbb{R}^n} \left\{ \|A\vec{x} - \vec{y}\|_2^2 + \lambda \|\vec{x}\|_1 \right\}

    其中A∈Rm×n,y⃗∈RmA\in\R^{m\times n},\vec{y}\in\R^m。

  • LASSO回归具有如下性质:记f0(x⃗)=∥Ax⃗−y⃗∥22+λ∥x⃗∥1f_0(\vec{x})=\|A\vec{x} - \vec{y}\|_2^2 + \lambda \|\vec{x}\|_1,则

    1. f0:Rn→Rf_0:\R^n\to\R为凸函数;
    2. 若AA列满秩,则f0f_0为μ\mu-强凸函数,其中μ=2σn{A}2\mu=2\sigma_n\{A\}^2;
    3. 最优解x⃗∗=arg min⁡x⃗∈Rnf0(x⃗)\displaystyle\vec{x}^*=\argmin_{\vec{x}\in\R^n}f_0(\vec{x})总存在,且当AA列满秩时最优解唯一。

    由此可以发现,LASSO回归与岭回归最大的区别在于LASSO回归并不保证解唯一,且没有解的显式表达式。

    • 那么引入LASSO回归有什么作用呢?实际上,LASSO回归得到的解往往具有较少的非零分量,这种性质也被称为稀疏性(sparsity)。
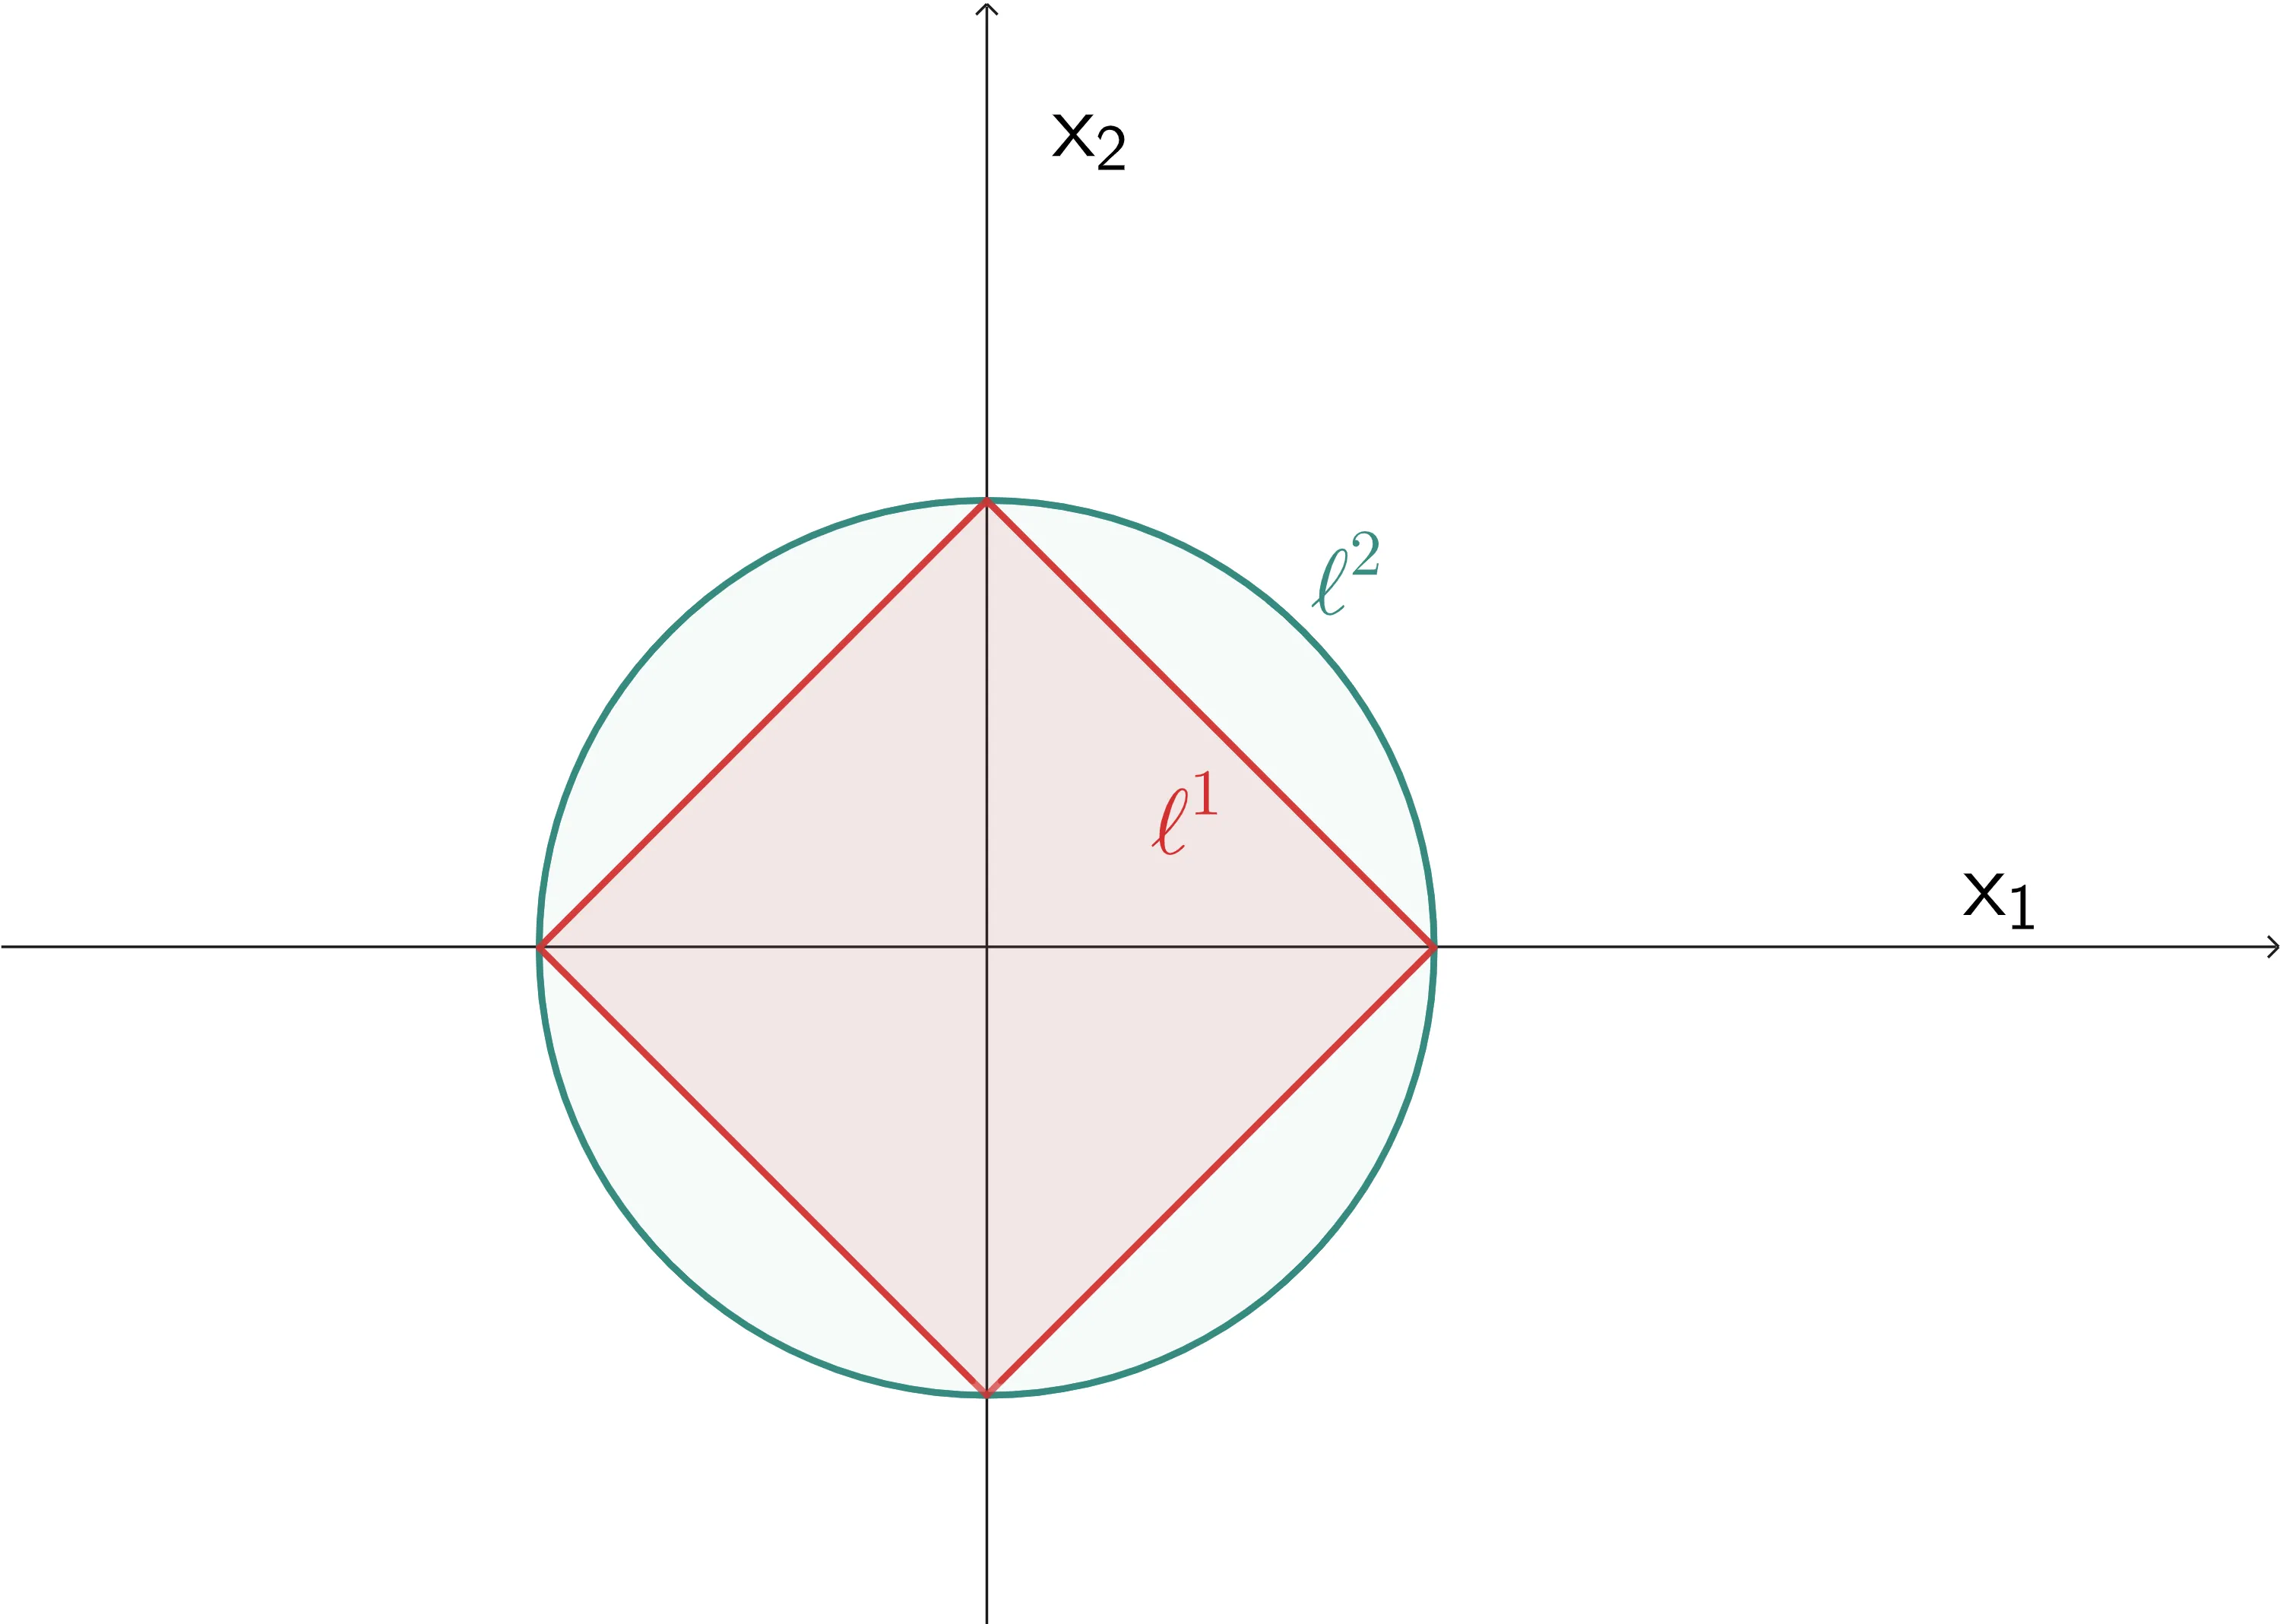
  • 下面我们通过对ℓ2\ell^2范数与ℓ1\ell^1范数进行比较理解这种稀疏性。首先,我们给出二维情形下的范数球,如图所示(实际上在Chapter 2中我们也已经画过类似的图):regularizer
    由此可以发现,ℓ2\ell^2范数球比较圆滑,而ℓ1\ell^1范数球相对棱角分明一些。这直观地说明了ℓ2\ell^2范数处处可微,而ℓ1\ell^1范数在xi=0x_i=0时不可微。而这些不可微点正是稀疏性产生的关键。

  • 在讨论LASSO回归的稀疏性问题之前,我们首先引入两个基本的范数优化问题:

    1. 最小ℓ1\ell^1范数问题
      之前我们利用KKT的平稳性条件解决了最小ℓ2\ell^2范数问题,然而对于最小ℓ1\ell^1范数问题:

      min⁡x⃗∈Rn∥x⃗∥1s.t.Ax⃗=y⃗.\begin{aligned} \min_{\vec{x}\in\R^n}\quad&\|\vec{x}\|_1\\ \text{s.t.}\quad&A\vec{x}=\vec{y}. \end{aligned}

      我们无法直接使用平稳性解决。对此,我们考虑将其转换为线性规划问题。引入x⃗\vec{x}的正部x⃗+\vec{x}^+与负部x⃗−\vec{x}^-,其满足

      x⃗i+,x⃗i−≥0,x⃗i+−x⃗i−=x⃗i,x⃗i++x⃗i−=∣xi∣.\vec{x}_i^+,\vec{x}_i^-\geq 0,\quad \vec{x}_i^+-\vec{x}_i^-=\vec{x}_i,\quad \vec{x}_i^++\vec{x}_i^-=|x_i|.

      因此上述问题可以转化为

      min⁡x⃗+,x⃗−∈Rn∑i=1n(xi++xi−)s.t.A(x⃗+−x⃗−)=y⃗x⃗+≥0⃗x⃗−≥0⃗.\begin{aligned} \min_{\vec{x}^+, \vec{x}^- \in \mathbb{R}^n} \quad & \sum_{i=1}^n (x_i^+ + x_i^-) \\ \text{s.t.} \quad & A(\vec{x}^+ - \vec{x}^-) = \vec{y} \\ & \vec{x}^+ \geq \vec{0} \\ & \vec{x}^- \geq \vec{0}. \end{aligned}

      这样就可以用LP方法求解。

      补充

      实际上,这个转化后的问题最终得到的最优解(x⃗+)∗(\vec{x}^+)^*与(x⃗−)∗(\vec{x}^-)^*中一定有一个是0⃗\vec{0}。可用反证法证明:

      • 如果(x⃗+)∗>0⃗(\vec{x}^+)^*>\vec{0}且(x⃗−)∗>0⃗(\vec{x}^-)^*>\vec{0},不妨设(x⃗+)∗>(x⃗−)∗(\vec{x}^+)^*>(\vec{x}^-)^*,那么可以另取(x⃗+)′=(x⃗+)∗−(x⃗−)∗,(x⃗−)′=0⃗(\vec{x}^+)'=(\vec{x}^+)^*-(\vec{x}^-)^*,(\vec{x}^-)'=\vec{0}。此时仍然满足约束条件,且目标函数更小,矛盾!

      由此可知引入的两个(松弛)变量完全可以使用正部与负部的定义。

      另一方面,这个问题也可以推广到一般的最小ℓ1\ell^1范数∥Ax⃗−y⃗∥1\|A\vec{x}-\vec{y}\|_1,只需做一个松弛变量转换即可:

      min⁡x⃗∈Rn ∥Ax⃗−b⃗∥1⟹min⁡x⃗∈Rn∥e⃗∥1s.t.e⃗=Ax⃗−b⃗.\min_{\vec{x}\in\R^n}\ \|A\vec{x}-\vec{b}\|_1\quad \Longrightarrow\quad \begin{aligned} \min_{\vec{x}\in\R^n}\quad &\|\vec{e}\|_1\\ \text{s.t.}\quad &\vec{e}=A\vec{x}-\vec{b}. \end{aligned}
    2. 最小距离问题
      设x⃗1,⋯ ,x⃗k∈Rn\vec{x}_1,\cdots,\vec{x}_k\in\R^n,考虑下述两种最小距离问题:

      min⁡x⃗∈Rn∑i=1k∥x⃗−x⃗i∥22min⁡x⃗∈Rn∑i=1k∥x⃗−x⃗i∥2\begin{aligned} \min_{\vec{x}\in\R^n}\sum_{i=1}^k\|\vec{x}-\vec{x}_i\|_2^2\\ \min_{\vec{x}\in\R^n}\sum_{i=1}^k\|\vec{x}-\vec{x}_i\|_2 \end{aligned}

      第一个问题的目标函数为可微凸函数,我们可以直接通过求梯度零点得到最优解:

      x⃗∗=1k∑i=1nx⃗i\vec{x}^*=\frac{1}{k}\sum_{i=1}^n\vec{x}_i

      即样本点均值。而对于第二个问题,目标函数不可微,对此我们先考虑n=1n=1(退化为标量)的情形:

      min⁡x∈R∑i=1k∣x−xi∣\min_{x\in\R}\sum_{i=1}^k|x-x_i|

      对这个目标函数求梯度需要分类讨论,推导如下:

      ddx∑i=1k∣x−xi∣=∑i=1kddx∣x−xi∣=∑i=1k{1,if x>xi−1,if x<xiundefined,if x=xi={∑i:x>xi1+∑i:x<xi−1,if x∉{x1,…,xk}undefined,if x∈{x1,…,xk}={∣{i∈{1,…,k}:x>xi}∣−∣{i∈{1,…,k}:x<xi}∣,if x∉{x1,…,xk}undefined,if x∈{x1,…,xk}.\begin{aligned} \frac{\mathrm{d}}{\mathrm{d}x} \sum_{i=1}^k |x - x_i| &= \sum_{i=1}^k \frac{\mathrm{d}}{\mathrm{d}x} |x - x_i| \\ &= \sum_{i=1}^k\begin{cases} 1, & \text{if } x > x_i \\ -1, & \text{if } x < x_i \\ \text{undefined}, & \text{if } x = x_i \end{cases} \\ &= \begin{cases} \sum_{i: x > x_i} 1 + \sum_{i: x < x_i} -1, & \text{if } x \notin \{x_1, \dots, x_k\} \\ \text{undefined}, & \text{if } x \in \{x_1, \dots, x_k\} \end{cases} \\ &= \begin{cases} |\{i \in \{1, \dots, k\}: x > x_i\}| - |\{i \in \{1, \dots, k\}: x < x_i\}|, & \text{if } x \notin \{x_1, \dots, x_k\} \\ \text{undefined}, & \text{if } x \in \{x_1, \dots, x_k\}. \end{cases} \end{aligned}

      因此梯度为00满足的条件为∣{i∈{1,…,k}:x>xi}∣=∣{i∈{1,…,k}:x<xi}∣|\{i \in \{1, \dots, k\}: x > x_i\}| = |\{i \in \{1, \dots, k\}: x < x_i\}|,实际上满足这一条件的解就是样本中位数。

      当然也需要考虑不可微点x1,⋯ ,xkx_1,\cdots,x_k,但综合考虑后最终得到的最优解仍然是样本中位数。

      由数理统计的知识可知,样本中位数相比样本均值更加稳定,因此第二个问题的解抗干扰性更强。

  • 现在正式讨论LASSO回归问题。这里我们只考虑决策变量为一维标量的情形,对于高维情形可以通过类似推导得出。问题形式如下:

    min⁡x∈RfLASSO(x⃗)fLASSO(x)≔12∥a⃗x−y⃗∥22+λ∣x∣=12∥a⃗∥22x2−(a⃗⊤y⃗)x+λ∣x∣+12∥y⃗∥22.\begin{aligned} \min_{x\in\R}\quad&f_{\text{LASSO}}(\vec{x})\\ &f_{\text{LASSO}}(x)\coloneqq\frac{1}{2}\|\vec{a}x-\vec{y}\|_2^2+\lambda|x|=\frac{1}{2}\|\vec{a}\|_2^2x^2-(\vec{a}^\top\vec{y})x+\lambda|x|+\frac{1}{2}\|\vec{y}\|_2^2. \end{aligned}

    由此可见目标函数除了x=0x=0之外均可微,具体导数如下:

    dfLASSO(x)dx=a⃗⊤(a⃗x−y⃗)+λ{1,if x>0−1,if x<0undefined,if x=0.\frac{\mathrm{d} f_{\text{LASSO}}(x)}{\mathrm{d}x} = \vec{a}^\top (\vec{a}x - \vec{y}) + \lambda \begin{cases} 1, & \text{if } x > 0 \\ -1, & \text{if } x < 0 \\ \text{undefined}, & \text{if } x = 0. \end{cases}

    下面对xx进行分类讨论:

    1. x>0x>0:此时 dfLASSO(x)dx=a⃗⊤(a⃗x−y⃗)+λ=0⟹xLASSO∗=a⃗⊤y⃗−λ∥a⃗∥22.\frac{\mathrm{d} f_{\text{LASSO}}(x)}{\mathrm{d}x}=\vec{a}^\top (\vec{a}x - \vec{y})+\lambda=0\Longrightarrow x^*_{\text{LASSO}}=\frac{\vec{a}^\top\vec{y}-\lambda}{\|\vec{a}\|_2^2}.
    2. x<0x< 0:此时 dfLASSO(x)dx=a⃗⊤(a⃗x−y⃗)−λ=0⟹xLASSO∗=a⃗⊤y⃗+λ∥a⃗∥22.\frac{\mathrm{d} f_{\text{LASSO}}(x)}{\mathrm{d}x}=\vec{a}^\top (\vec{a}x - \vec{y})-\lambda=0\Longrightarrow x^*_{\text{LASSO}}=\frac{\vec{a}^\top\vec{y}+\lambda}{\|\vec{a}\|_2^2}.
    3. x=0x=0:由上述两个讨论可知,最优解要取在x≠0x\neq 0,需要满足∣a⃗⊤y⃗∣>λ|\vec{a}^\top\vec{y}|>\lambda。因此当∣a⃗⊤y⃗∣≤λ|\vec{a}^\top\vec{y}|\leq\lambda时,原问题的最优解xLASSO∗=0x^*_{\text{LASSO}}=0。

    综上,我们得到最优解的形式:

    xLASSO∗={a⃗⊤y⃗−λ∥a⃗∥22,if a⃗⊤y⃗>λa⃗⊤y⃗+λ∥a⃗∥22,if a⃗⊤y⃗<−λ0,if −λ≤a⃗⊤y⃗≤λ.x_{\text{LASSO}}^* = \begin{cases} \dfrac{\vec{a}^\top \vec{y} - \lambda}{\|\vec{a}\|_2^2}, & \text{if } \vec{a}^\top \vec{y} > \lambda \\[10pt] \dfrac{\vec{a}^\top \vec{y} + \lambda}{\|\vec{a}\|_2^2}, & \text{if } \vec{a}^\top \vec{y} < -\lambda \\[10pt] 0, & \text{if } -\lambda \leq \vec{a}^\top \vec{y} \leq \lambda. \end{cases}

    这恰好体现了LASSO回归的“软阈值”性质:它会在a⃗⊤y⃗\vec{a}^\top \vec{y}接近00时让x∗x^*直接取00。【而岭回归只有a⃗⊤y⃗=0\vec{a}^\top \vec{y}=0时才会让x∗x^*取00】这也是LASSO回归具有稀疏性的原因。

  • 正则化与凸优化问题的约束条件也有密切关系。具体定理如下:

    • 设f0:Rn→Rf_0: \mathbb{R}^n \to \mathbb{R}为严格凸函数,并且对于所有满足lim⁡t→∞∥x⃗t∥2=∞\displaystyle\lim_{t\to\infty} \|\vec{x}_t\|_2 = \infty的序列(x⃗t)t=0∞(\vec{x}_t)_{t=0}^\infty,都有lim⁡t→∞f0(x⃗t)=∞\displaystyle\lim_{t\to\infty} f_0(\vec{x}_t) = \infty(这一条件也称为coercivity条件);

    • 同时假设R:Rn→R+R: \mathbb{R}^n \to \mathbb{R}_+为非负凸函数,且存在x⃗0∈Rn\vec{x}_0 \in \mathbb{R}^n使得R(x⃗0)=0R(\vec{x}_0) = 0;

    • 另设R(λ)\mathcal{R}(\lambda)和C(k)\mathcal{C}(k)分别为正则化和带约束凸优化问题的解集:

      R(λ)≔arg min⁡x⃗∈Rn{f0(x⃗)+λR(x⃗)}C(k)≔arg min⁡x⃗∈RnR(x⃗)≤kf0(x⃗)\begin{aligned} \mathcal{R}(\lambda) &\coloneqq \argmin_{\vec{x} \in \mathbb{R}^n} \{ f_0(\vec{x}) + \lambda R(\vec{x}) \}\\ \mathcal{C}(k) &\coloneqq \argmin_{\substack{\vec{x} \in \mathbb{R}^n \\ R(\vec{x}) \le k}} f_0(\vec{x}) \end{aligned}

      其中λ≥0,k≥0\lambda \ge 0,k \ge 0。则:

      • 对于任意λ≥0\lambda \ge 0,都存在k≥0k \ge 0,使得R(λ)=C(k)\mathcal{R}(\lambda) = \mathcal{C}(k);【此时kk取值R(R(λ))R(\mathcal{R}(\lambda))】
      • 对于任意k>0k > 0,都存在λ≥0\lambda \ge 0,使得R(λ)=C(k)\mathcal{R}(\lambda) = \mathcal{C}(k)。【R(arg min⁡x⃗∈Rnf0(x⃗))≤k\displaystyle R\left(\argmin_{\vec{x}\in\R^n}f_0(\vec{x})\right)\leq k时取λ=0\lambda=0,否则只需要满足R(R(λ))=kR(\mathcal{R}(\lambda))=k即可】

      这一定理表明在某种意义上,正则化凸优化问题等价于带约束的凸优化问题。

      • 一个简单的应用:岭回归问题与带ℓ2\ell^2范数约束的最小二乘问题等价。【前提是矩阵列满秩】
  • 最后我们再利用上面的范数球说明LASSO的稀疏性原理:假设一个优化问题(不考虑范数约束)的全局最优解在范数球外,现在将其水平集以最优解为中心向外扩散。那么:

    • 对于ℓ1\ell^1范数球约束,其最终得到的最优解往往会在范数球的角上(水平集最先碰到角),从而具有稀疏性;
    • 而对于ℓ2\ell^2范数球约束,其最终得到的最优解可能是球上的任意一点,因而不具备稀疏性。